Double page 22
Les réseaux profonds
Un neurone seul ne sait pas faire grand-chose. Mais assemblés par milliers ou par millions, en couches successives, les neurones artificiels deviennent capables de reconnaître un visage, une voix ou une phrase.
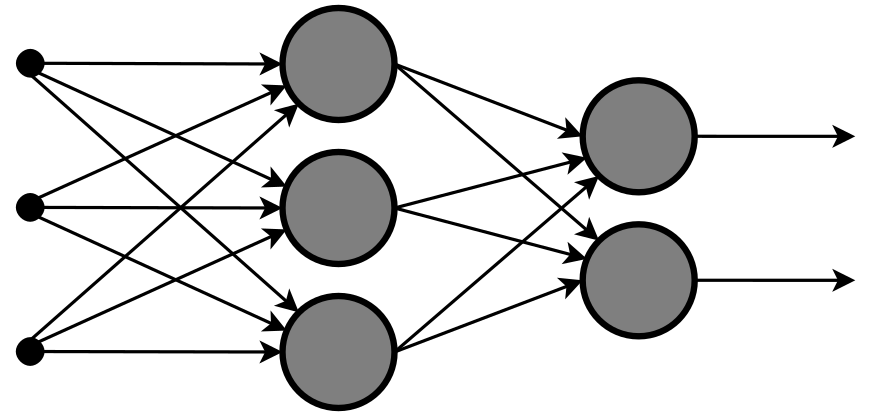
Des couches empilées
Un réseau de neurones est organisé en couches :
- la couche d’entrée reçoit les données brutes, par exemple les pixels d’une image ;
- les couches cachées, au milieu, transforment progressivement ces données ;
- la couche de sortie donne le résultat, par exemple « visage » ou « pas visage ».
Chaque neurone d’une couche transmet ses résultats aux neurones de la couche suivante. Quand le réseau compte beaucoup de couches cachées, on parle d’apprentissage profond (deep learning).
Du simple au complexe
Dans un réseau qui reconnaît des visages, les chercheurs ont observé que :
- les premières couches repèrent des éléments simples : des contours, des lignes, des contrastes ;
- les couches intermédiaires assemblent ces éléments en formes : un œil, un nez, une bouche ;
- les dernières couches combinent ces formes pour reconnaître un visage entier.
Personne n’a programmé ces étapes : le réseau les a découvertes seul pendant l’entraînement.
Comment le réseau apprend-il ?
Au début, tous les poids sont réglés au hasard. Le réseau fait une prédiction, on mesure son erreur, puis on remonte le réseau de la sortie vers l’entrée pour ajuster légèrement chaque poids dans la direction qui réduit l’erreur. Cette méthode, appelée rétropropagation, est répétée des millions de fois.
Pour les curieux : la descente de gradient Imagine que tu sois perdu dans le brouillard en montagne et que tu veuilles rejoindre le fond de la vallée. Tu ne vois rien, mais tu sens la pente sous tes pieds : tu fais un pas dans la direction qui descend le plus. Puis un autre. C’est le principe de la descente de gradient : à chaque étape, le réseau ajuste ses poids dans la direction qui diminue le plus l’erreur. La rétropropagation, popularisée en 1986 notamment par Geoffrey Hinton, permet de calculer cette direction efficacement.
Des réseaux géants
Les premiers réseaux comptaient quelques centaines de poids. Les grands modèles de langage actuels en comptent des centaines de milliards, voire davantage. On les appelle aussi paramètres.